Gemini 3使用教程:10分钟看懂多模态智能体Gem与Nano Banana 2协同玩法
1. 多模态理解
它能够读取文字、查看图片、观看视频、听取音频,输入格式不受限制。这是 Gemini 从第一代起就具备的基础能力,到第三代已经更加成熟。
2. Gem 智能体
这部分才是关键。Gem 是 Gemini 中的智能体功能,类似 ChatGPT 的 GPTs,但整体设计更轻量。你可以把自己的知识库、提示词、风格要求打包成一个“分身”,下次直接调用。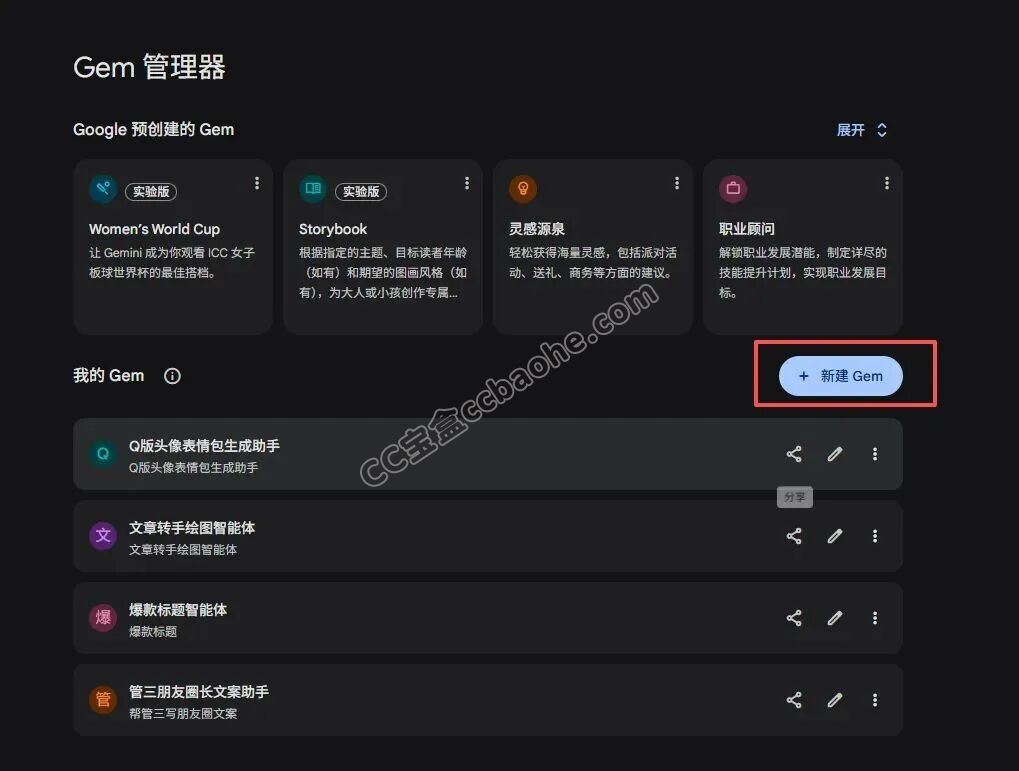
3. 与 Nano Banana 2 的协同
Gemini 3 负责对话和推理,Nano Banana 2 负责图像生成,两者配合使用。在 Gemini 对话框中,看到带有香蕉图标的功能入口,就是调用 Nano Banana 2 的位置。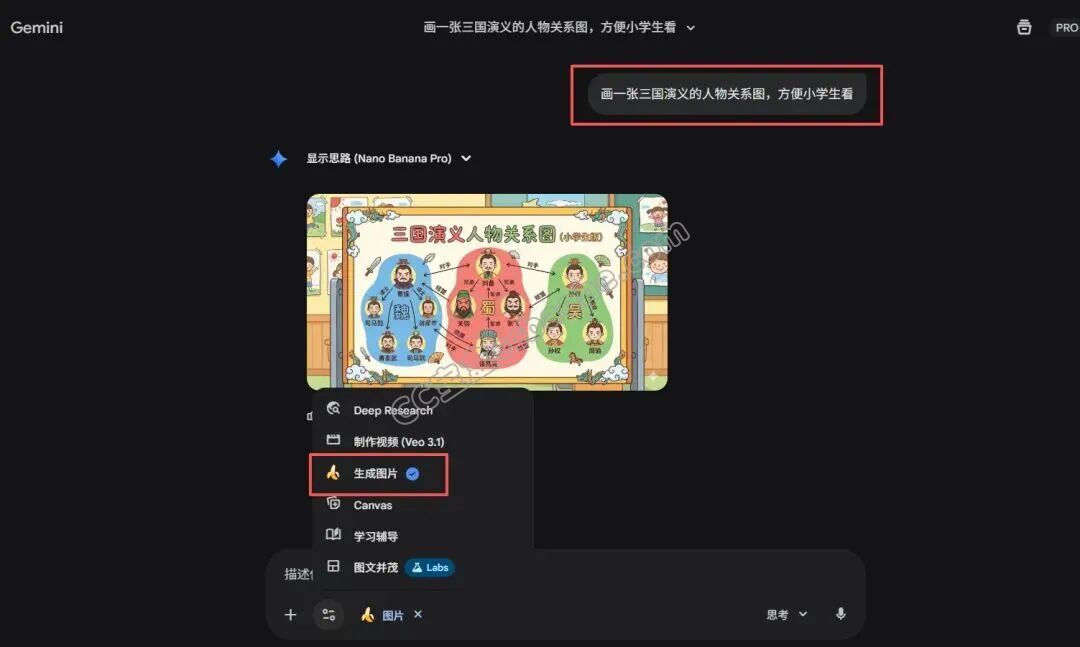
怎么用起来
入口主要有两个:入口一:Google Gemini 官网(gemini.google.com),适合直接对话和日常使用。入口二:Google AI Studio(aistudio.google.com/apps),面向开发者的工作台,可以构建应用、调用 API、集成 Google Search 数据。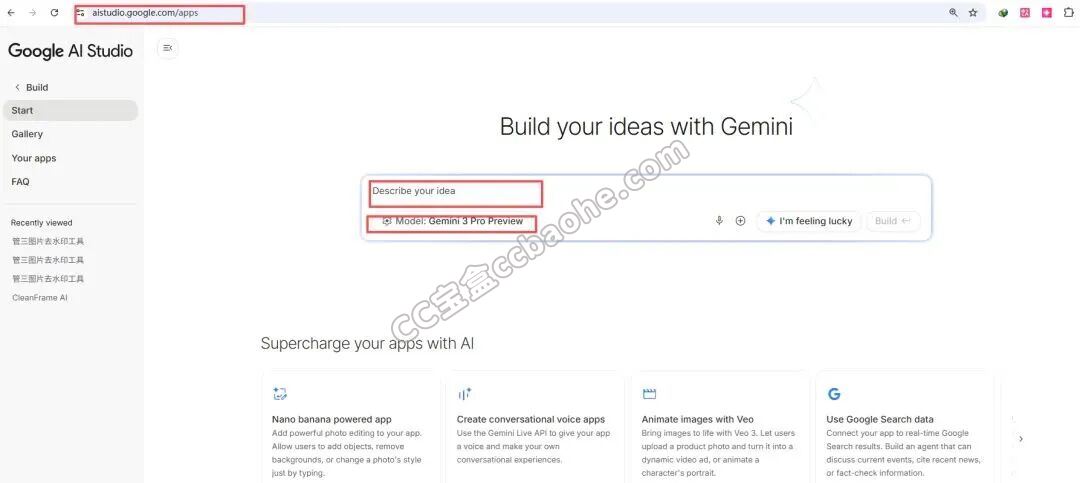
搭建智能体的步骤,以 Gem 为例:
进入 Gemini 官网,点击“探索 Gem”
点击“新建 Gem”,填写名称和说明
编写指令(提示词)。这一步非常重要,直接决定智能体的行为表现
适合做什么
结合实际测试,以下几个场景是 Gemini 3 真正有优势的地方:
1. 个人 IP 内容创作。这是最核心的用途。把自己的知识库输入给它,它可以生成带有个人风格和经历的朋友圈长文、公众号文章,不容易出现一眼可辨的“AI 味”。原理就是大模型、提示词、知识库三者配合到位。
2. 文章转视觉内容。把一篇文章交给它,让它分析内容结构,再转化为手绘思维导图或知识信息图,适合制作知识卡片和内容分发所需的视觉素材。
3. 高审美 PPT 生成。通过 NotebookLM(基于 Gemini 能力的应用)直接生成 PPT,审美表现在线,甚至能自动绘制时间线和金句卡片。
4. 快速开发小工具。Gemini 3 的编程能力较强。例如我曾用它在一分钟内做了一个图片去水印工具,直接在电脑上运行,基本不需要修改 Bug。
5. 定制 IP 表情包。上传自己的照片,让 Nano Banana 2 生成一套 Q 版表情包,支持 9 至 12 种表情状态,包括“吃瓜”“躺平”“摸鱼”“真香”等中文互联网常见梗。
不适合做什么
这一部分原文没有展开,但实际使用下来,有几个限制需要注意:
1. 不适合做高精度数值计算。这是大模型的通病,Gemini 3 也不例外。财务对账、精确统计等场景不宜依赖它。
2. 不适合处理需要严格数据隐私的逻辑。数据需要经过 Google 的服务器,敏感业务数据应谨慎使用。国内合规场景也需要额外评估。
3. 不适合做超长上下文的高强度推理任务。虽然 Gemini 的上下文窗口很大,但到尾部区域注意力衰减明显,长文档深处的细节容易丢失。
4. 不适合做需要低延迟响应的生产系统。调用 API 的延迟通常高于本地部署模型,不适合对响应时间要求严苛的在线服务。
5. 不适合做需要频繁切换模型的场景。切换模型需要手动修改配置,目前缺少类似 cc-switch 那样的一键切换工具来统一管理 Gemini 与其他模型的调度。
总结一下Gemini 3 最大的价值在于“智能体 + 知识库 + 多模态”的组合。如果你从事个人 IP、内容创作、知识可视化等方向,它可以帮你节省不少时间。但如果你需要的是高精度、低延迟、强隐私保障的场景,它可能不是最优选择。最后说一句:目前这些工具都提供免费额度,建议先用免费额度体验,确认真正成为刚需后再考虑开通会员。
```
