Grok 4.7使用指南:最便宜的前沿模型值不值得换?附定价分析与API调用教程
1
马斯克的新模型,便宜得有点意外
Grok 4.7 于9月21日正式发布。到现在将近一周,讨论热度仍在持续攀升。
我关注它,并非因为它是最强的——说实话,综合能力它排不到第一。而是因为它的定价策略。
输入 $2 / 1M tokens,输出 $6 / 1M tokens。
作为对比,GPT-6 Astra 是 $10 / $50,Claude Opus 5 是 $15 / $75。Grok 4.7 的输出价格仅为 GPT-6 的八分之一、Claude 的十二分之一。
从标价来看,它是目前最便宜的前沿模型。
但先别急着换。这篇文章想跟你聊清楚三件事:它到底有多强、标价背后有哪些隐藏成本、以及什么人真正适合用它。
2
比 4.6 强了多少
先看硬数据。官方公布的 benchmark 对比,Grok 4.7(xhigh 档)对上一代 4.6(high 档):
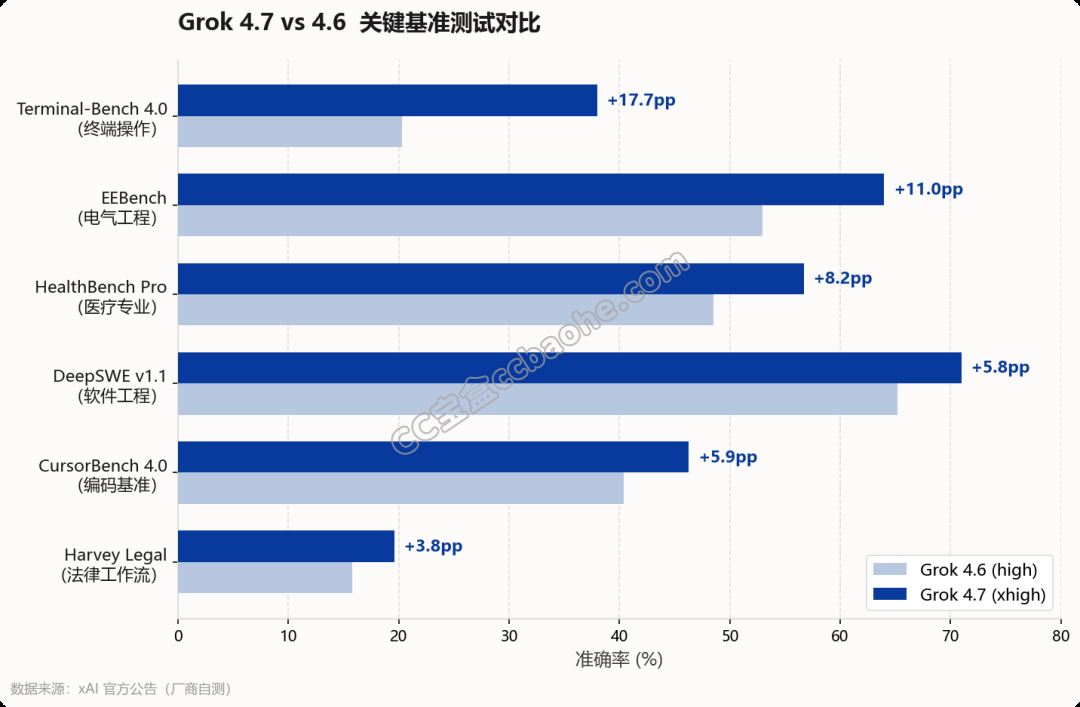
▲ Grok 4.7(xhigh) vs Grok 4.6(high) 关键基准对比
挑几个重点说明。
Terminal-Bench 4.0 —— 从 20.3% 提升至 38.0%,上涨 17.7 个百分点。这是 Agent 终端操作能力,提升幅度最大,说明 4.7 在“工具使用”方面投入了大量优化。
EEBench(电气工程) —— 从 53.0% 提升至 64.0%,增加 11 个百分点。该成绩在官方榜单上位列第一,远超 GPT-5.6 Sol 的 39.4%。电气工程是 Grok 的传统强项,此次继续扩大优势。
DeepSWE v1.1 —— 从 65.2% 提升至 71.0%,增加 5.8 个百分点。软件工程基准,71% 是什么水平?GPT-6 Astra 为 73.7%,Claude Opus 5 为 74%。Grok 4.7 已摸到第二梯队的天花板。
Harvey Legal Agent —— 从 15.8% 提升至 19.6%,法律工作流基准,同样位列官方榜单第一。
但有一件事需要提前说明。
注意:以上数据来自 xAI 官方公布。独立第三方(Artificial Analysis)的实测分数要低一些,例如 Terminal-Bench 4.0 实测约 26-27%(官方 38%)。差距主要源于测试方法和 harness 框架的不同——套用 Grok Build 自家框架时分数更高,脱离后会有所下滑。
3
定价和两个容易踩的坑
先看定价表。
计费项≤ 200K tokens> 200K tokens输入$2.00 / 1M$4.00 / 1M缓存命中输入$0.50 / 1M$1.00 / 1M输出$6.00 / 1M$12.00 / 1M
第一个坑,200K 临界点。
并非超过的部分才翻倍,而是整个请求都翻倍。199K 的提示按 $2 计算,201K 的提示则全部按 $4 计算。仅差 2K token,价格即翻一倍。
实操建议:如果你的提示经常在 200K 上下浮动,务必注意控制。差几千 token 就触发翻倍,很不划算。要么压缩到 200K 以内,要么确认超过 200K 后带来的价值确实值得双倍价格。
第二个坑,话痨体质。
这是 Grok 4.7 最被低估的成本因素。独立测试数据显示,xhigh 档下 Grok 4.7 每个任务平均消耗约 8.1 万输出 token,是 GPT-6 Astra(2.7 万)的近 3 倍。
这意味着什么?标价上 Grok 的输出是 GPT-6 的 1/8,但它说的话是 GPT-6 的 3 倍。实际单任务成本的差距,就从 8 倍缩小到了不到 3 倍。
Cursor 社区已有用户反馈,同样的任务,Grok 4.7 消耗的 token 几乎是 4.6 的两倍。以前那种“用 Grok 省钱”的感觉,正在消失。
标价便宜 ≠ 实际便宜。计算成本时,别忘了把 token 消耗量也算进去。
4
核心功能速查
功能支持备注Function Calling✓工具调用Code Execution✓代码执行Vision 图像理解✓文本+图像输入Web Search✓网页搜索X 实时搜索✓独家功能JSON Mode✓结构化输出推理强度档位✓low / medium / high / xhigh图像生成△需调用独立模型Batch API✗不支持开放权重✗闭源
重点说两个 Grok 独有的功能。
X 实时搜索 —— 这是 Grok 最大的差异化功能。因为 xAI 与 X(原 Twitter)同属一家,Grok 可以直接搜索 X 上的实时内容。做舆情监控、追踪热点、观察行业动态,这个功能相当好用。其他模型搜不到如此新鲜的社交数据。
四档推理强度 —— low、medium、high、xhigh。档位越高,推理越深入,token 消耗也越多。默认是 high 档。如果你对成本敏感,可以尝试 medium 档,大部分日常任务可能够用。
5
和 GPT-6、Claude 怎么选
直接说结论。
选 Grok 4.7 的场景 —— 预算有限但想用前沿模型、从事电气工程或法律相关工作、需要 X 实时搜索、大量 Agent 任务对 token 消耗不敏感。简单说,追求性价比、愿意为价格牺牲一点巅峰能力的,选 Grok。
选 GPT-6 Astra 的场景 —— 追求综合能力最强、任务成功率第一、Computer Use 桌面操作、生态最完善(插件/App/开发者工具最多)。不差钱、要最好的,选 GPT-6。
选 Claude Opus 5 的场景 —— 长文档处理(200万上下文)、代码审查质量最高、写作风格最自然、企业部署需求。追求深度和长上下文的,选 Claude。
一个更实际的建议:别只选一个。
现在的玩法是,主力模型用一个(比如 GPT-6 或 Claude),然后备一个便宜的模型跑大批量任务。Grok 4.7 特别适合做“第二模型”——大量数据处理、批量分类、初步分析这些对成本敏感的任务,扔给 Grok 跑,省下来的钱用在关键任务上。
好钢用在刀刃上,批量活交给便宜模型。
6
API 调用上手
Grok 的 API 是 OpenAI 兼容格式,切换起来很简单。
from openai import OpenAI client = OpenAI( api_key="xai-你的KEY", base_url="https://api.x.ai/v1" ) response = client.chat.completions.create( model="grok-4.7", reasoning_effort="high", messages=[{"role": "user", "content": "你好,介绍一下你自己"}] ) print(response.choices[0].message.content)
获取 API Key 的步骤:
1. 访问 console.x.ai,注册 xAI 账号
2. 在控制台找到 API Keys 部分
3. 点击 Create API Key,命名后立即复制保存
4. 密钥格式是 xai- 开头,只显示一次,丢了找不回
注意:reasoning_effort 参数可选 low / medium / high / xhigh。默认 high。xhigh 能力最强但 token 消耗最多。如果你的任务比较简单,试试 medium 档,可能能省不少钱。
7
最后说两句
Grok 4.7 发布的时候,我看到很多人说“又一个新模型,卷起来了”。
但说实话,今年的模型发布节奏,已经不是“卷”能形容的了。
Grok 4.7 发布当天,官方公告里提了一句——Grok 4.8 已经训练完成了。
4.7 还没捂热,4.8 已经在排队了。
这意味着什么。以前我们讨论模型,会说“今年最强模型是谁”。后来变成“这季度最强是谁”。现在呢,可能下个月就有更新的版本出来。
模型的生命周期,正在以肉眼可见的速度缩短。
对我们用户来说,这不一定是坏事。选择越来越多,价格越来越便宜,能力越来越强。但也有一件事越来越重要——别把所有鸡蛋放在一个模型上。
学会在不同任务上用不同模型,学会根据成本和质量的平衡点做选择,可能比“找到最强的那个模型”更重要。
最强的模型年年有。但会选模型的能力,才是你自己的。
