Sora人物一致性实测:一张参考图生成30秒对话短片,参考图生视频完整流程
你有没有想过,只需要一张图,就能生成一段有对话、有表情、有动作的完整短片?
不是特效大片,不是专业团队,就是你一个人,一张参考图,加上几行提示词。
这件事现在真的可以做到了。
先说结论
Sora在文生视频的人物一致性上,表现出乎意料地稳定。
单个10秒片段内,人物的面容、服饰、发型发饰等细节,保持得相当好。你不用担心角色“换脸”或者突然变装。
但是——
如果你想把多个10秒片段串联成一个完整短片,单靠文字提示词是不够的。你需要用到参考图功能,让Sora认准角色。
真人图有坑,换个思路
真人写实风格的参考图,目前Sora不支持上传。
这个限制直接把我引向了另一个方向:用即梦生成国风二次元动漫风格的角色图,拿这张图去做参考。
结果怎么样?
一致性还是可以的。但说实话,如果你用即梦里偏3D国风效果的人物去测,生成出来的视频和原图风格差异挺大的。这一点要提前有预期。
实测流程,手把手
我在即梦里用这个提示词生成了参考图:
国风二次元动漫风格,古风,年轻的男生(束发,穿蓝色汉服)和女生(长发,穿白色汉服),半身正面特写,看向镜头,背景是纯色。
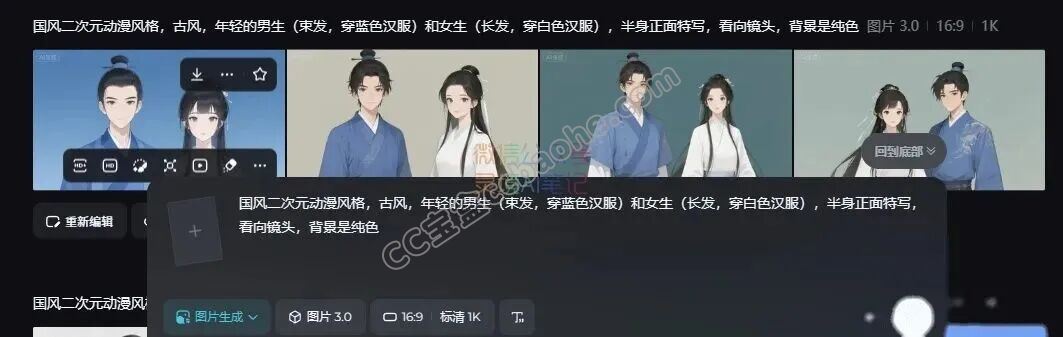
拿到这张图之后,把它发给豆包,让豆包根据图片为两个人设计一段故事,然后补充两人之间的对话台词。
故事有了,对话有了,接下来就是把这些内容整理成分镜提示词,输入给Sora。
顺序就是这样:出图 → 设计故事 → 补充对话 → 写分镜提示词 → 生成视频。
提示词参考
我制作了3段10秒视频,每段包含2个分镜,加起来刚好构成30秒的完整短片。
这里分享其中一段的提示词,供大家参考:
根据参考图,左边是男(穿蓝色汉服,系黑色腰带),右边是女(穿白色汉服,系白色腰带),请保持好人物的一致性和风格的一致性。0-5秒:中国国风二次元动漫风格,古风,江南水乡,细雨濛濛,青石板路湿漉漉的。男子撑着油纸伞在桥头与捧着一摞书、却不慎将书本散落在地的女子相遇。女子(慌张失措,弯腰去捡)说:“书都掉地上了!”男子(温和解围)说:“我帮你捡起来。”5-10秒:中国国风二次元动漫风格,古风,书院里,男子于窗边认真读书,女子捧着一本书,怯生生地向他请教问题。女子(腼腆局促,指尖攥着书页)说:“这道题我不会做。”男子(耐心温和,指尖点向书本)说:“我来教你怎么做。”
对话内容略显生硬,毕竟是纯测试,看个逻辑即可。
有意思的是,我最初并没有在提示词里加入对话,但Sora自己给视频配上了人物说话的声音。所以我后来干脆把台词直接写进去,结果更加可控。
目前最大的问题
声音。
每个10秒片段的声音风格不统一,听起来割裂感比较明显。这是目前Sora参考图生视频最明显的短板,暂时没有很好的解决方案。
画面一致性:过关。
声音一致性:还有明显差距。
期待后续版本能把这块补上。
这个玩法能做什么
短片创作、动漫故事、IP角色展示……你只需要一张设计好的角色图,剩下的交给AI来演绎。
这已经不是“辅助创作”了,而是真正在降低内容生产的门槛。以前需要一个团队才能完成的事,现在一个人就能跑通流程。
方向很清晰,工具也在快速迭代。现在入手研究,比等到人人都会了再学,要值得多。
