Midjourney三种出图方式全解析:文生图、垫图生图与多图融合实战教程
用了半年 Midjourney,却只会一个操作:在输入框里打字。想做出“跟这张图风格一致”的画面,完全不知道从何下手;手里有张产品图,想让 AI 换个背景,结果硬是把产品描述成文字打了进去,出来的图跟产品毫无关联;看到别人把几张图“合成”一张神图,以为用了什么高端技术,其实只是没搞懂 Midjourney 的第二、第三种喂图方式。
Midjourney 的出图方式远不止“打字”一种。按输入类型的不同,可以分为三种:
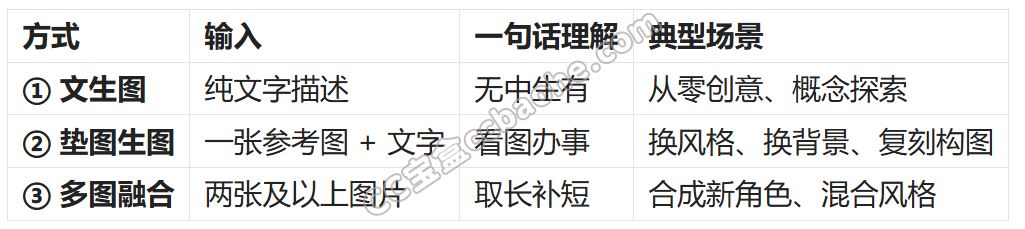
这篇文章就把三种方式的应用场景、操作方法和常见坑,一次性讲清楚。
一、先建立直觉:三种方式,对应三种“喂法”
把 Midjourney 想象成一位画师,你喂给它什么,它就据此画什么:
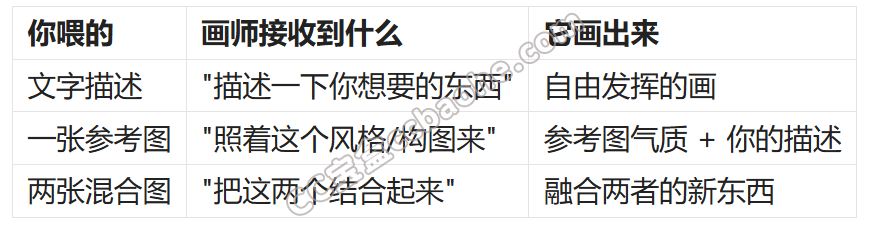
一句话记住:文字定“内容”,参考图定“风格/结构”,多图定“融合方向”。三种方式并非孤立,高阶玩家通常混合使用——垫一张图、加一句描述,偶尔再叠一张参考图。
二、方式①:文生图——从零开始
怎么用
在输入框直接输入描述文字,回车,等待4张候选图。这是所有方式的基础,前两篇已经详细讲过,这里不再赘述。
什么时候用
脑海中只有一个模糊概念,还没有具体参考;
探索性创作:想看看 AI 对某个词的4种理解;
没有现成素材可用,需要“无中生有”。
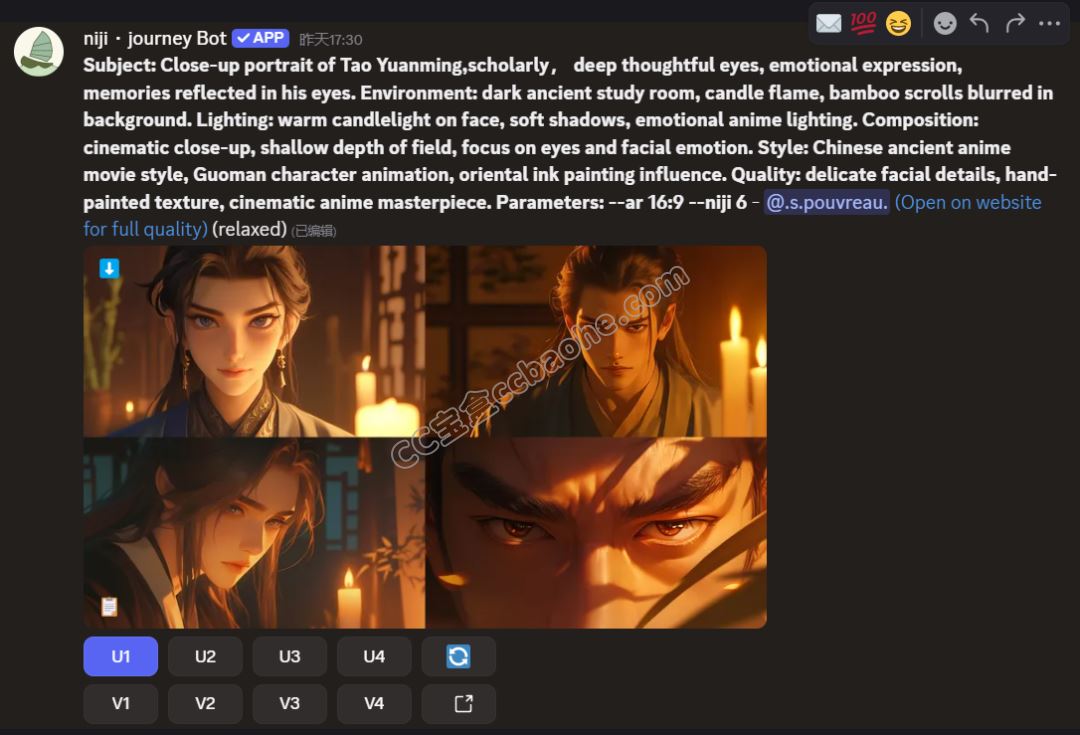
关键心法:文生图的成败,全在“描述够不够具体”。只写 “a man” 只能得到平庸的画面,将提示词写出画面感才能得到有味道的作品。具体名词 + 氛围词,是文生图的基本功。
三、方式②:垫图生图——照着参考图来
怎么用(网页端)
点击输入框左侧的图片上传按钮,或直接把图片拖拽进输入框;
图片出现在输入框中后,输入你想要改动的文字描述;
回车,Midjourney 会结合这张参考图 + 你的描述出图。
比如上传一张人物照片,输入“相应的环境”——它会理解图中是个人,然后按“给定环境”的方向重新绘制。
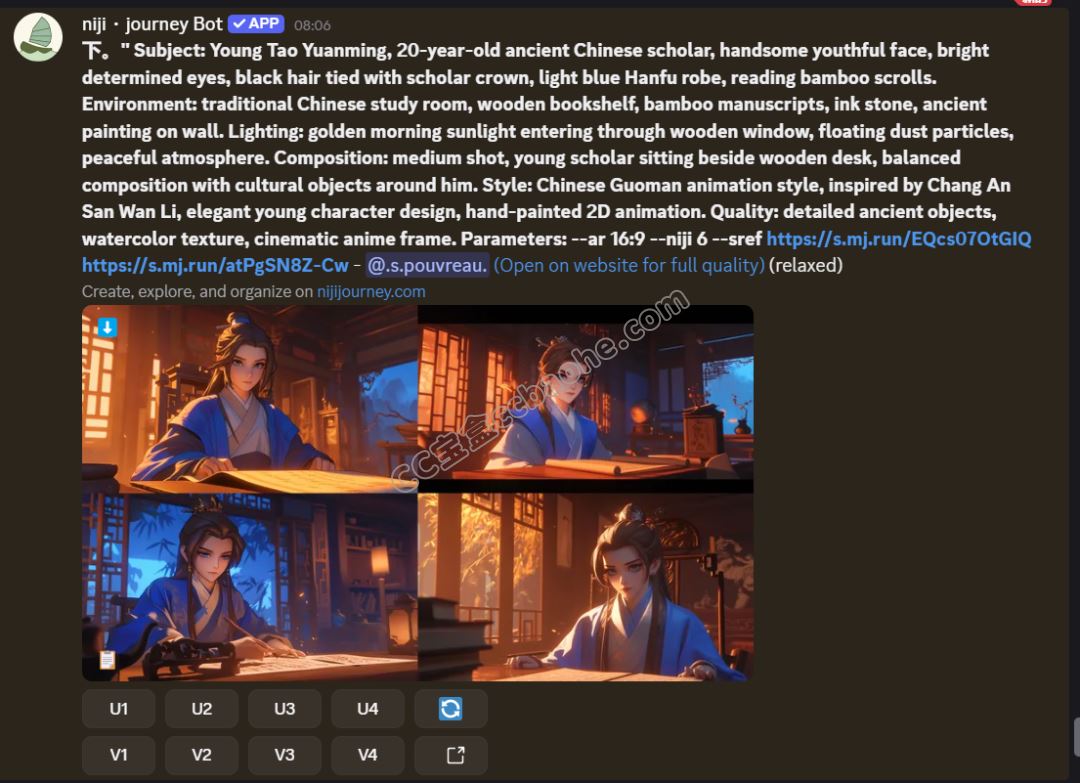
什么时候用
换风格:一张实物图 → “在油画风格中重绘”;
换背景:产品图 → “放在雪山前的广告背景”;
复刻构图:喜欢某张图的构图,想换成自己的主体;
IP角色延续:让同一个角色穿不同的衣服、出现在不同场景。
垫图的核心是:参考图提供“结构/内容”,你的文字提供“变化方向”。两者配合,才能做到既像又新。
四、方式③:多图融合——取长补短
怎么用
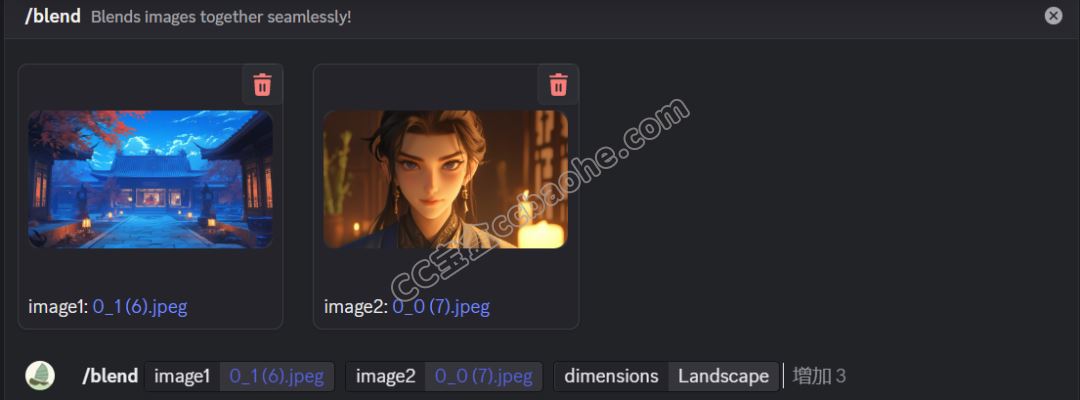
一次上传两张或更多图片;
不加文字,或加一句轻量的方向描述;
Midjourney 会把多张图的特征融合,生成新的合成结果。
什么时候用
把“角色 A 的脸”和“角色 B 的服装”合成一个新角色;
把“建筑的形态”和“水彩的风格”混合成一张概念图;
给甲方展示“几个方向的结合体”长什么样。
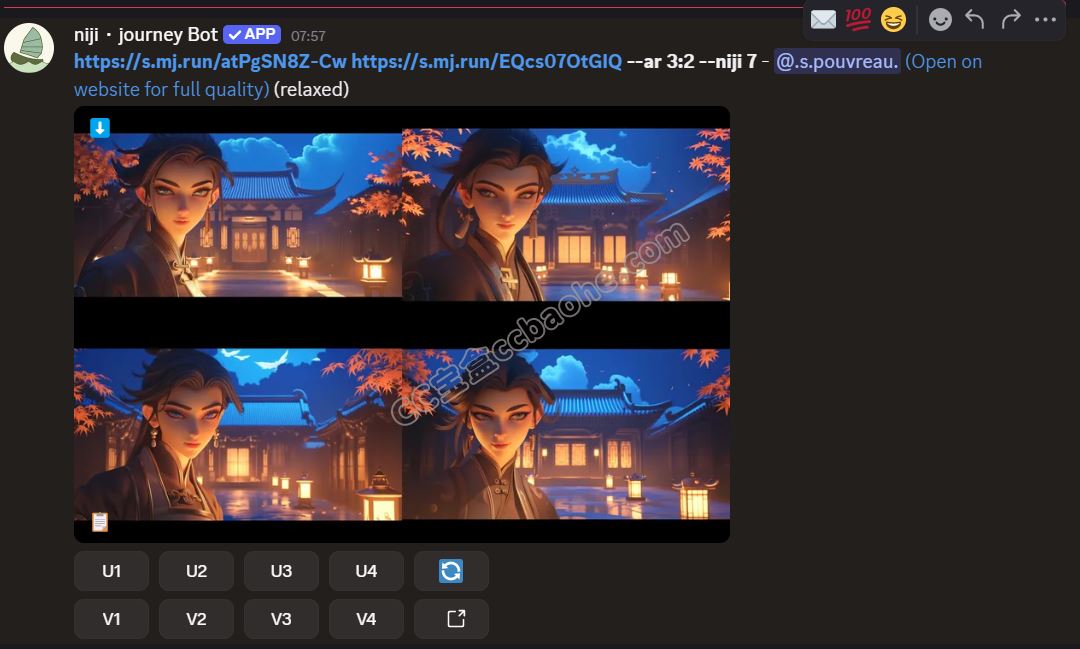
真实案例①:一位游戏原画师给角色做设计,把“概念稿 A 的铠甲”“概念稿 B 的配色”“参考照片 C 的光影”三张图丢进融合,几分钟得到一张兼具三者优点的方向稿,再进 PS 精修,一版就过了。以前靠手绘拼方案,至少要大半天。
真实案例②:有朋友做自媒体封面,想要“自己照片的氛围 + 某张爆款封面的排版感”。她用垫图 + 一段描述文字,让 Midjourney 按爆款封面的构图重绘自己的照片,点击率肉眼可见地上涨——参考的不是“画风”,而是“版式逻辑”。
五、三种方式的常见坑
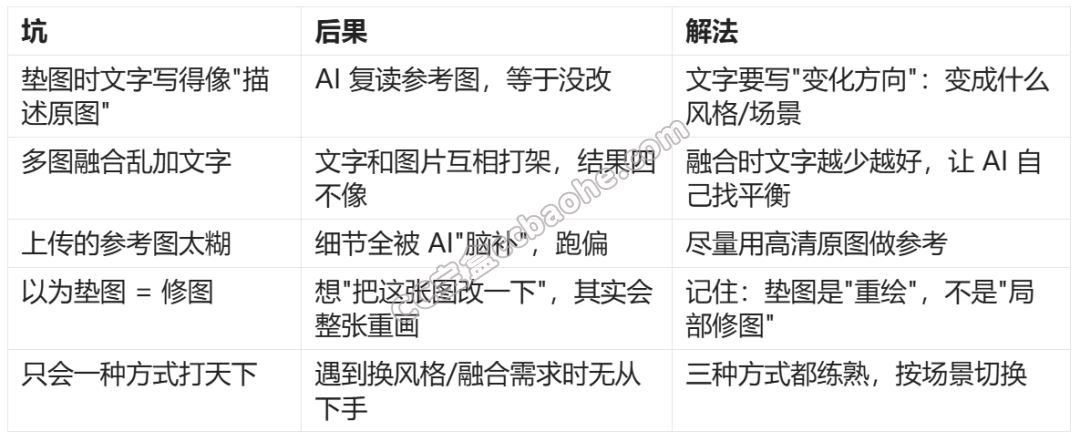
六、知识总结图
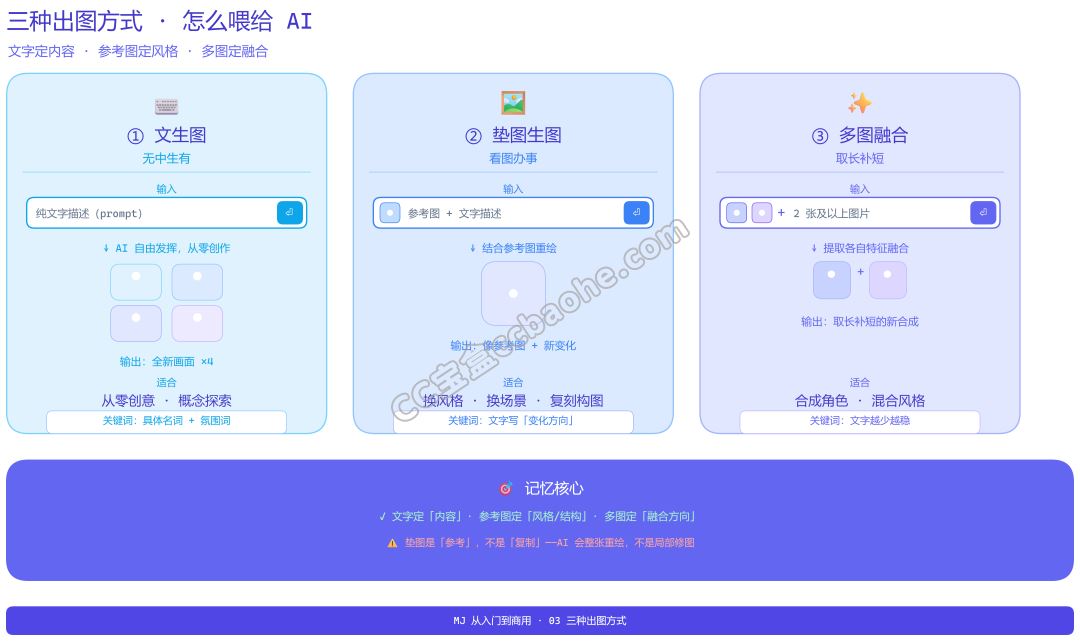
文生图 × 垫图 × 多图融合,三条路一次看全,忘了随时回看。